

形式语言与自动机理论
概述
形式语言(Formal languages)和自动机的理论(Theory of automata)是计算理论(Theory of computation)和数学的一个理论分支,而计算理论又是计算机科学(computer science)和数学的一个分支,它的建立得益于英国数学家阿兰.图灵(Alan Mathison Turing)为帮助解决大卫.希尔伯特(David Hilbert)提出的数理逻辑中一阶逻辑的判定性问题而构想的图灵机,虽然它是一种纯属虚构的计算机,或许连计算机假设都谈不上,但它却意外促使了一个新领域(计算理论或可计算性)研究的横空出世。其主要关注三个方面的问题: 采用什么计算模型(即形式语言-Formal Language、自动机理论-Automata Theory);解决哪些是能计算的、哪些是不能计算的(即可计算性理论-Computability theory);要用多少时间、要用多少存储(即计算复杂性理论-Computational Complexity Theory)。它使我们理解了计算机真实世界的正式数学模型的建立,它还帮助我们理解不同的算法、硬件和软件。
自动机理论是研究抽象机器(称为自动机)及其行为。它在20世纪建立了它的根基,数学家们开始开发模仿人类某些特征的机器,无论是理论上还是字面上,都能更快、更可靠地完成计算。通过自动机,计算机科学家能够理解机器如何计算函数和解决问题,更重要的是,将函数定义为可计算的或将问题描述为是否可判定。在计算机科学中,自动机用作计算机和计算过程的动态数学模型,用来研究计算机的体系结构、逻辑操作、程序设计乃至计算复杂性理论;在语言学中,把自动机作为语言识别器,用于研究各种形式语言;在神经生理学中将自动机定义为神经网络的动态模型,用于研究神经生理活动和思维规律;在生物学中,将自动机作为生命体的生长发育模型以研究新陈代谢与遗传变异;在数学中用自动机定义可计算函数,研究各种算法。
自动机理论是形式语言理论的基础,用于生成和识别不同的形式语言,因此它们是密切相关的。
形式语言理论是处理将语言表示为字母表上的操作集合。它最早由诺姆·乔姆斯基(Noam Chomsky)在20世纪50年代在研究自然语言的过程中,将复杂性层次的自动机理论思想扩展到了形式语言层次,从而引出了形式语法的概念且给出了一个语法的数学模型。形式语言研究领域关注语言的语法及其内部结构模式。不久之后,当编程语言ALGOL的语法由上下文无关语法定义时,语法的概念被发现对程序的设计非常重要。这种发展自然导致了语法导向编译和编译器编译器的概念。从那时起,发生了一系列的活动,其结果与形式语言和自动机理论相关,以至于不可能单独处理这些领域。到目前为止,如果不了解形式语言和自动机理论的技术和结果,任何对计算机科学的认真研究都不可能完成。语言学由于形式语言领域的兴起,自然语言的句法规律现在有了理解的手段。语言也可以由任何类型的自动机定义,如图灵机。一般来说,在字母表A上运行的任何自动机或机器M都可以产生完全有效的语言L。例如,系统可以用有界的图灵机磁带表示,每个单元代表一个单词。指令停止后,任何值为1(或ON)的单词都会被接受,并成为生成语言的一部分。形式语法系统是一种专门为语言目的定义的自动机。与纯数学自动机一样,语法自动机只需要几个符号和几个生成规则就可以生成各种复杂的语言。乔姆斯基的层次结构定义了四个嵌套的语言类(即正则语言、上下文无关语言、上下文有关语言与递归可枚举语言),其语法生成规则有更严格的限制。
形式语言和自动机理论的应用范围已被扩展到生物工程、自动控制系统、图像处理与模式识别等诸多领域。
自动机理论(Theory of automata)
“自动机(Automata)”来源于希腊语“αὐτόματα”,意思是“自我表达”。自动机(Automata in plural)是一种抽象的自推进计算设备,它自动遵循预定的操作顺序。自动机(automata)起源于与“自动化(automation)”密切相关的“自动机(Automaton)”一词,表示执行特定过程生产的自动化过程。具有不同复杂性的真实或假设自动机已经成为研究和实现具有可用于数学分析的结构的系统的不可或缺的工具。诺伯特·维纳(Norbert Wiener)和艾伦·M·图灵被视为该领域的先驱。通用自动机的最佳例子是电子数字计算机。自动机网络可以设计成模仿人类行为。
自动机的起源与发展
1936年,英国数学家艾伦·马西森·图灵(Alan Mathison Turing)在《伦敦数学学会会刊》(Proceedings of the London Mathematic Society)上发表的一篇论文(《论可计算数及其在Entscheidungs问题中的应用》)中构想了一种逻辑机器,其输出可用于定义可计算数。对于机器来说,时间被认为是离散的,在给定时刻,它的内部结构被简单地描述为一组有限的状态之一。它通过扫描被划分为正方形的无界磁带来执行其功能,每个正方形要么以有限数量的符号之一的形式包含特定信息,要么是空白的。它一次只能扫描一个方块,如果处于任何内部状态,除了所谓的“被动”状态,它能够一次向前或向后移动一个方块、擦除一个符号、如果方块为空则打印一个新符号,并改变其自身的内部状态。计算出的数字由磁带有限部分上的符号(“程序”)和操作规则决定,其中包括在达到被动状态时停止。然后根据机器停止后磁带上剩余的符号解释输出编号。
在20世纪建立了它的根基,数学家们开始开发模仿人类某些特征的机器,无论是理论上还是字面上,都能更快、更可靠地完成计算。自20世纪中叶以来,自动机理论得到了广泛的改进,并经常在民用和军用机器中得到实际应用。通过自动机,计算机科学家能够理解机器如何计算函数和解决问题,更重要的是,将函数定义为可计算的或将问题描述为是否可判定。
现代计算机的存储库可以存储大量(虽然有限)信息。最初的图灵机器对内存库没有限制,因为无界磁带上的每个方块都可以容纳信息。在自动机理论的基本讨论中,图灵机仍然是一个标准的参考点,许多关于可计算性的数学定理已经在图灵机最初的建议框架内得到了证明。
自动机的构造(物理构造和逻辑构造)
自动机的部件由特定的材料和设备组成,如电线、晶体管、杠杆、继电器、齿轮等,它们的操作基于这些部件的机械和电子原理。然而,它们作为一系列离散状态的操作原理可以独立于其组件的性质或排列来理解。通过这种方式,可以抽象地将自动机视为一组物理上未指定的状态、输入、输出和操作规则,而自动机的研究则是对这些状态、输入和输出的研究。这种抽象模式产生的数学系统在某些方面类似于逻辑系统。因此,自动机可以被描述为逻辑定义的实体,其可以以机器的形式体现,术语自动机指定物理构造和逻辑构造。
自动机定义与分类
自动机( automaton)是机器的抽象模型,通过移动一系列状态或配置来对输入执行计算。在计算的每个状态,转换函数基于当前配置的有限部分确定下一配置。因此,一旦计算达到接受配置,它就接受该输入。
自动机一般可分为四大类,其中最通用和最强大的自动机是图灵机。
- 有限状态机(FSM Finite-state machine)
- 下推自动机(PDA Pushdown automata)
- 线性有界自动机(LBA Linear-bounded automata)
- 图灵机(Turing machine)
自动机本质上可被理解为根据纸带的数量、长度和移动以及所使用的读写操作分类的图灵机,我们可通过以下方式限制图灵机的能力:
- 若使用TAPE作为STACK,则它将是“PDA”
- 若使TAPE有限,则它将是“FSM”
- 若TAPE大小等于输入大小,则为“LBA”
上面2和3间的主要差别在于:对于有限自动机,无论输入大小如何,TAPE的大小都是固定的,而对于LBA,TAPE大小将不同:输入越大,TAPE越大,输入越小,TAPE就越小。
不同自动机之间的主要区别在于它们能够使用的存储空间有所差异:
- 有限状态自动机只能用状态来存储信息
- 下推自动机除了使用状态以外,还可以用下推存储器(堆栈)
- 线性界线自动机可以利用状态和输入/输出带本身,因为输入/输出带没有“先进后出”的限制
- 图灵机等价于无约束文法
自动机理论是计算机科学和数学的一个理论分支。发展自动机理论的主要动机是开发描述和分析离散系统动态行为的方法。所谓离散状态自动机有时用于强调内部状态的离散性质。主要类别是转换器(transducers )和接收器(acceptors)。
转换器(transducer)
在自动机理论中,转换器(transducer)是具有输入和输出的自动机,任何用于计算部分递归函数的图灵机都可以作为一个例子。最重要的转换器是有限转换器或顺序机,它可以被描述为具有输出的单向图灵机。在计算能力方面,它们是最弱的,而通用机器是最强的,另外还有中等能力的转换器。可以分为两种子类型,即moore machine (摩尔型有限状态机)和mealy machine (米利型有限状态机),其中:
- 若输出只和状态有关而与输入无关,则称为moore状态机
- 输出不仅和状态有关而且和输入有关系,则称为mealy状态机
接收器(acceptor)
接收器(acceptor)是一个没有输出的自动机,在特殊意义上,它识别或接受机器字母表上的单词。接受器的输入以通常的方式写在纸带上,但在计算结束时纸带是空白的,输入单词的接受由称为最终状态的特殊状态表示。自动机理论的一个基本结果是,每个递归可枚举集或部分递归函数的范围都是一个可接受的集。一般来说,接收器是双向无界的纸带自动机。语言学家诺姆·乔姆斯基(Noam Chomsky)在美国提出了生成语法理论,并结合这一理论对接收器进行了有益的分类。生成语法是一种通常与语言学相一致的分析系统。通过这种方式,语言可以被视为一组规则,数量有限,可以产生句子。在语言学或自动机理论的背景下,生成语法的使用是为了生成和划分一种语言的语法结构的整体,无论是自然的还是面向自动机的。可以分为以下四种子类型:
- Recursively enumerable grammars and Turing acceptors
- Finite-state grammars and finite-state acceptors
- Context-free grammars and pushdown acceptors
- Context-sensitive grammars and linear-bounded acceptors
自动机的应用
自动机理论在计算理论、编译器生产、人工智能等领域非常有用。
- 有限自动机(FA): 编译器词法分析的设计、正则表达式识别、使用Mealy和Moore机器设计组合和时序电路、文本编辑器、拼写检查器、人工智能中的学习和决策的模型、解析文本以提取信息和结构数据。
- 下推自动机(PDA): 设计编译器的语法分析、实现堆栈、计算算术表达式、用于软件工程,验证和验证软件模型的正确性、在网络协议中使用,用于解析和验证传入的消息,并强制执行特定的消息格式、密码学中实现加密和解密的安全算法、字符串匹配和模式识别、XML分析、自然语言处理如解析句子、识别词性和生成语法树、自动定理证明和形式验证、硬件和软件系统的验证。
- 线性有界自动机(LBA): 实现遗传编程、识别上下文相关语言、博弈论中用于建模和分析代理之间的交互。
- 图灵机(TM): 解决任何递归可枚举问题、理解复杂性理论、实现神经网络、机器人、人工智能、分析算法的时间和空间复杂性的理论模型、计算生物学中用于模拟和分析生物系统、人工智能中用作学习和决策的模型、研究经典计算和量子计算之间的关系、用于数字电路设计,用于模拟和验证数字电路的行为、用于人机交互,对人与计算机之间的交互进行建模和分析。
总之,自动机是用于表示和分析计算系统行为的数学模型。该理论涉及形式语言及其与自动机的关系的研究。自动机理论的基本概念是有限自动机,它是一种识别有限字母表上的字符串的简单机器。有限自动机可以被认为是有限状态机的数学模型,有限状态机是一种机器,它可以处于有限数量的状态之一,并根据其接收的输入在状态之间进行转换。自动机理论中的另一个重要概念是正则语言的概念,这是一种可以被有限自动机识别的形式语言。正则语言在形式语言的研究中很重要,有很多应用,包括编译器的设计和编程语言中正则表达式的实现。自动机理论的研究还包括下推自动机的概念,下推自动机是具有存储信息堆栈的自动机,这是通用计算机的数学模型。形式语言和自动机的理论被用于计算机科学的许多领域,包括编译器、算法以及计算机辅助设计和验证的算法。它也用于复杂性理论的研究,为算法及其复杂性的研究提供了基础。
有限状态机(FSM Finite-state machine)
用于计算的最简单的自动机是有限自动机。它只能计算非常原始的函数;因此,它不是一个适当的计算模型。此外,有限状态机无法概括计算阻碍了它的能力。第一批考虑有限状态机概念的人包括生物学家、心理学家、数学家、工程师和一些最早的计算机科学家。他们都有一个共同的兴趣:模拟人类的思维过程,无论是在大脑中还是在计算机中。沃伦·麦卡洛克和沃尔特·皮茨,两位神经生理学家,在1943年首次提出了有限自动机的描述。他们的论文题为“神经活动中固有的逻辑演算”,对神经网络理论、自动机理论、计算理论和控制论的研究做出了重大贡献。后来,两位计算机科学家G.H.Mealy和E.F.Moore在1955-56年发表的独立论文中将这一理论推广到更强大的机器上。有限状态机,Mealy机和Moore机,因其工作而得名。虽然Mealy机器通过当前状态和输入确定其输出,但Moore机器的输出仅基于当前状态。
具有有限数量状态的自动机称为有限状态机(FSM finite state machine)也被称为有限自动机(finite automata)。
有限自动机的正式定义可以用5元组M=(Q,Σ,δ,q 0,F)表示,其中:
- Q是一组有限状态。
- Σ是一组有限的符号,称为自动机的字母表。
- δ是过渡函数。
- q 0是从那里的任何输入被处理(Q初始状态0 ∈Q)。
- F是Q(F⊆Q)的最终状态/状态的集合。
根据上面的数学解释,可以说有限状态机包含有限数量的状态。每个状态都接受有限数量的输入,每个状态都有规则来描述机器对任何输入的动作,这些规则在状态转换映射函数中表示。同时,输入可能导致机器改变状态。对于每个输入符号,每个状态都有一个转换。此外,任何被非确定性有限自动机接受的5元组集合也被确定性有限自动机所接受。
有两种类型的有限自动机:
- 确定性有限自动机(DFA Deterministic Finite Automata):在DFA中,对于每个输入字符,计算机只运行到一个状态。这里,计算的唯一性被称为确定性。DFA不接受空移动。
- 非确定性有限自动机(NFA Non-deterministic Finite Automata):NFA用于发送特定输入的任意数量的状态。它能够接受空移动。
可以根据有没有输出分为两类:
- 有输出的有限状态机:Moore Machine、Mealy Machine
- 无输出的有限状态机:DFA、NFA、ϵ-NFA
由于内存量有限且恒定,FSM的内部状态不具有进一步的结构。它们可以很容易地用状态图表示。

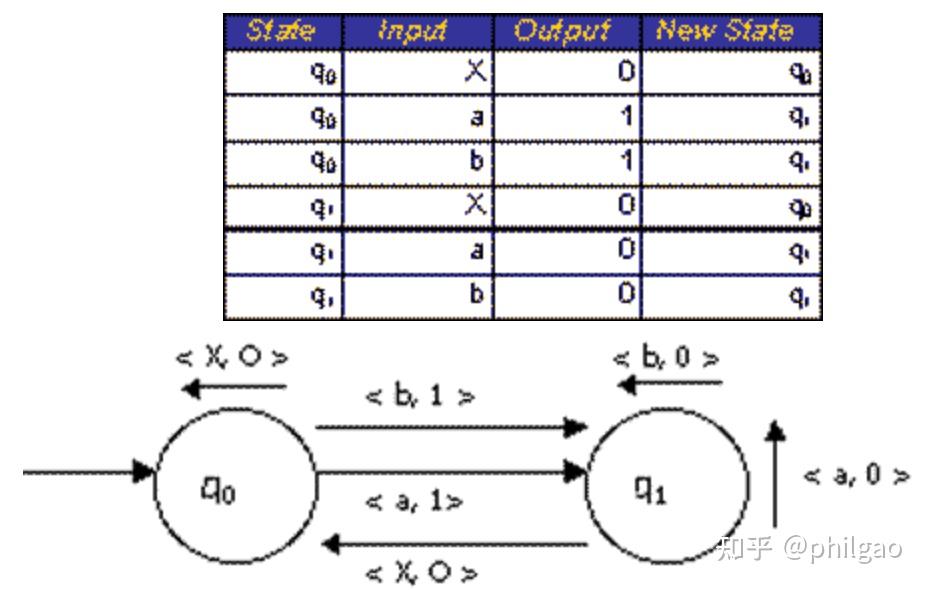
状态图说明了自动机的操作。状态由图的节点表示,过渡由箭头或分支表示,相应的输入和输出由符号表示。从左侧进入q0的箭头表示q0是机器的初始状态。不涉及状态更改的移动由单个节点两侧的箭头指示。这些箭头称为自循环。
存在几种类型的有限状态机,可分为三大类:
- 接受器( acceptors ):接受或不接受输入
- 识别器( recognizers ):识别输入或不识别输入
- 转换器( transducers ):从给定输入生成输出
有限状态机的应用可以在各种学科中找到。它们可以在具有有限单词数(标准情况)、无限单词数(Rabin自动机、Bïrche自动机)、各种类型树的语言上操作,也可以在硬件电路中操作,其中输入、状态和输出是固定大小的位向量。
下推自动机(PDA Pushdown automata)
下推自动机是有限状态机,在所谓的堆栈中增加了额外的内存。新元素被推入堆栈。这些机器可以做的更多比有限状态机,但不如图灵机。下推自动机存在“确定”与“非确定”两种形式,两者并不等价。(对有限状态自动机两者是等价的)。下推自动机作为一个形式系统最早于1961年出现在 Oettinger 的论文中。它与上下文无关文法的等价性是由乔姆斯基于1962年发现的。
如果把下推自动机扩展,允许一个有限状态自动机存取两个栈,将得到一个能力更强的自动机,这个自动机与图灵机等价。
下推自动机有三个组件:
- 输入带
- 控制单元
- 具有无限大小的堆栈
PDA可以正式描述为7元组M=(Q,∑,S,δ,q0,I,F),其中:
- Q是有限数量的状态
- ∑是输入字母表
- S是堆栈符号
- δ是过渡函数:Q×(∑⑪{ε})×S×Q×S*
- q0是初始状态(q0∈Q)
- I是初始栈顶符号(I∈S)
- F是一组接受状态(F∈Q)
线性有界自动机(LBA Linear-bounded automata)
线性有界自动机被认为是一种受限类型的图灵机。计算受到限制,在有限的有界区域内进行。可用作上下文有关语言的识别接受器。
1960年,Myhill引入了自动机模型,如今这种自动化模型被理解为确定性线性有界自动机。在此之后,另一位名叫Landweber的科学家对此进行了研究,并提出确定性LBA所接受的语言是持续的上下文敏感语言。
1964年,黑田东彦专门为非确定性线性有界自动机引入了一种替代模型和许多通用模型,并确定了非确定性线性有限自动机所接受的语言正是上下文敏感语言。
线性有界自动机(LBA)类似于图灵机,具有以下一些特征:
- 具有非确定性逻辑的图灵机
- 具有多轨道的图灵机
- 带有限长度带的图灵机
LBA可以正式描述为8元组M=(Q、T、E、q0、ML、MR、S、F)定义,其中:
- Q->有限的过渡态集
- T->磁带字母表
- E->输入字母表
- q0->初始状态
- ML->磁带左边界
- MR->磁带边界
- S->转换函数
- F->一组有限的最终状态
图灵机(Turing machine)
1936年,英国数学家艾伦·马西森·图灵(Alan Mathison Turing)在《伦敦数学学会会刊》(Proceedings of the London Mathematic Society)上发表的一篇论文(《论可计算数及其在Entscheidungs问题中的应用》)中构想了一种逻辑机器,其输出可用于定义可计算数。对于机器来说,时间被认为是离散的,在给定时刻,它的内部结构被简单地描述为一组有限的状态之一。它通过扫描被划分为正方形的无界磁带来执行其功能,每个正方形要么以有限数量的符号之一的形式包含特定信息,要么是空白的。它一次只能扫描一个方块,如果处于任何内部状态,除了所谓的“被动”状态,它能够一次向前或向后移动一个方块、擦除一个符号、如果方块为空则打印一个新符号,并改变其自身的内部状态。计算出的数字由磁带有限部分上的符号(“程序”)和操作规则决定,其中包括在达到被动状态时停止。然后根据机器停止后磁带上剩余的符号解释输出编号。
图灵机由集合[Q,∑,Γ,δ,q0,B,F]正式定义,其中:
- Q=有限状态集,其中一个状态q0是初始状态
- ∑=Γ的子集,不包括B,是输入符号的集合
- Γ=允许带符号的有限集合
- δ=下一个移动函数,从Q xΓ到Q xΓx{L,R}的映射函数,其中L和R分别表示左和右方向
- q0=设置Q为开始状态
- B=Γ的符号,作为空白
- F⊆Q最终状态集
因此,图灵机和双向有限自动机(FSM)之间的主要区别在于图灵机能够改变磁带上的符号并模拟计算机的执行和存储。出于这个原因,可以说图灵机有能力对今天可以通过现代计算机计算的所有计算进行建模。
能被图灵机接受的字符串组成的语言称为递归可枚举语言。如果这个图灵机对于任何串都停机,则这个语言称为递归语言。
使用普通计算机是可以模拟图灵机的。尽管由于存储大小的限制,计算机实际上是状态数巨大的有限状态机,但是我们可以通过提醒人工更换硬盘来规避这一点。然而,普通计算机也可以用图灵机模拟,并且图灵机需要的步数和普通计算机相比只有多项式级别的区别。这件事比较显然,但较为复杂。我们用多个不同的带模拟计算机的不同部分,就可以用多带图灵机模拟普通计算机。于是普通计算机和图灵机的计算能力也是等同的。
形式语言(Formal languages)
自然语言处理的历史,在乔姆斯基(Noam Chomsky)之前所有关于自然语言处理的研究都是基于经验主义的,但由他在20世纪50年代发起,建立在阿克塞尔·图伊(Axel Thue)、艾伦·图灵(Alan Turing)和埃米尔·波斯特(Emil Post)的早期工作基础上,为语言理论提供了一个衡量标准,为描述的充分性设定了最低限度。建议对自然语言的经验领域进行一系列大规模的简化和抽象。特别是,这种方法完全忽略了意义。此外,与表达式使用有关的所有问题,如频率、上下文依赖性和处理复杂性都没有考虑在内。最后,假设对短字符串有效的模式以不受限制的方式应用于任意长度的字符串时至今日,不仅是语言学,理论计算机科学以及最近的分子生物学都表明,这些抽象概念被很好地选择了,保留了自然语言结构的基本方面。
乔姆斯基把语言定义为:按照一定规律构成的句子和符号串的有限或无限的集合。根据这个定义,无论哪一种语言都是句子和符号串的集合,当然自然语言也不例外,汉语、英语等所有自然语言,都是一个无限集合。构成这些集合的是句子、单词或其他符号。也可以把语言看成一个抽象的数学系统。无论把语言看作集合还是数学系统,我们都可以用数学的方法来进行刻画和描述。
无论哪种语言都是句子和符号串的集合,其描述的方法一般有以下三种:
- 穷举法:即把所有句子都枚举出来,显然适应性很窄。
- 文法(grammar)描述:为语言中的每个句子定义严格的构造规则,利用规则生成语言中合法的句子。
- 自动机(automata)法:通过对输入句子进行识别,从而判断哪些句子是属于语言的,哪些是属于语言的。
它们的区别在于:
- 文法是静态的、精确的描述语言及其结构。
- 自动机是动态的识别输入字符串是否属于语言的过程。
- NLP自然语言处理 (Natural Language Processing)中的识别和分析算法大多兼取两者之长。
对于语言的研究,实际上包括3个方面。
- 如何表示或描述一个语言。若该语言是有穷语言,则可使用穷举法列举出语言中所包含的所有字符串;若该语言是无穷语言,则对该语言的表示,需要考虑语言的有穷描述。
- 如何判定一个给定的语言是否存在有穷描述。并不是所有的语言都存在有穷描述,即对于某些语言,并不存在有穷表示。
- 具有有穷表示的语言的结构以及结构的特性问题。
任何语言都是结构化的交流媒介,无论是口语或书面自然语言、手语或编码语言,还是正式的编程语言。语言有两个基本要素——语法syntax(语法规则grammatical rules)和语义semantics (意义)。在某些语言中,其含义可能会因第三个因素(称为使用上下文)而有所不同。
自然语言、形式语言与编程语言
自然语言(Natural Language)就是人类讲的语言,如汉语、英语。其不是人为设计(虽然有人试图强加一些规则)而是自然进化的。形式语言(Formal Language)是为了特定应用而人为设计的语言。如数学家用的数字和运算符号等。编程语言也是一种形式语言,是专门设计用来表达计算过程的形式语言。20世纪60年代,美国人巴科斯(John Backus)和丹麦人诺尔(Peter Naur)在算法语言ALGOL60首次使用一种称为巴科斯-诺尔形式(BNF Backus-Naur form)的方法来描述程序设计语言的语法,极其类似于形式语言理论中的上下文无关文法。从此打开了形式语言广泛应用于描述程序设计语言的局面,使它发展成为理论计算机科学的一个重要分支。
形式语言的界限是明确的,而自然语言的界限往往不明确。因为自然语言有许多方言和习惯用法,而且处于不断发展之中。其次,自然语言不管如何庞大,它总是有限的。形式语言则以无限的语言为主要研究对象。例如,所有由n个ɑ构成的字(n≥1)组成一个语言Lɑ={ɑ,ɑɑ,ɑɑɑ,…},它就是无限的。因此,研究形式语言遇到的第一问题就是描述问题。描述的手段必须是严格的,而且必须能以有限的手段描述无限的语言。
形式语法(formal grammarr )或文法的定义
语法是描述和分析语言的有力工具。它是一组规则,用来构造语言中的有效句子。下面是一个英语语法的简单例子:

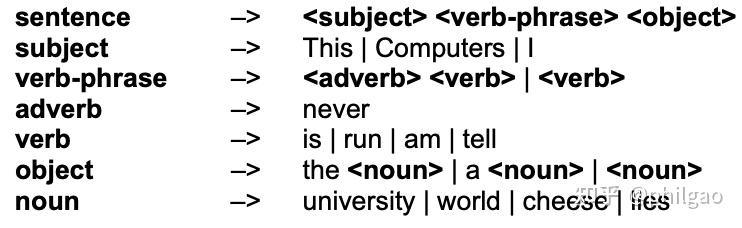
使用上述规则或产生式(productions),我们可以导出如下简单句子:

下面是上图中第一个句子(This is a university)使用产生式的最左推导的例子:

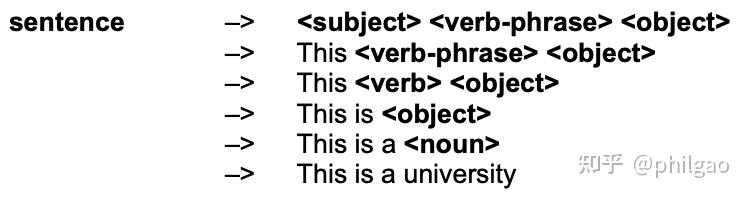
除了几个合理的句子,我们还可以推导出“Computers run cheese”和“This am a lies”之类的这些没有语义意义(semantic sense)的句子,但它们语法正确。形式语法是语法工具,而不是语义工具。在语法分析阶段,我们验证结构,而不是意义。
形式语言(也称代数语言学)是用来精确的描述语言(人工和自然语言)及其结构的手段。它只研究语言的组成规则,不研究语言的含义。形式语言的研究始于20世纪初,50年代中期将形式语言用于描述自然语言。
形式语法正式的定义是一个四元组(quadruple)G=(N,∑,P,S),其中:
- N是非终结符(non-terminal symbols)的有限集合;
- ∑是终结符(terminal symbols)的有限集合;
- N和∑不相交,V=N∪∑,称为总词表;
- P产生式(production rules)={α→β}是一组重写规则的有限集合,其中α ,β是由V中元素构成的串,但是α中至少应含有一个非终结符号;
- S∈N,称为句子符或初始符(start symbol )。
与纯数学自动机一样,语法自动机只需要几个符号和几个生成规则就可以生成各种复杂的语言。如果两个语法G和G’生成的语言L(G)和L(G’)是相同的,则它们是等价的。
句型与句子
文法G=(N,∑,P,S)的句子形式(句型)通过下面的递归方式定义
- S是一个句子形式;
- 如果γβα是一个句子形式,且β→δ是P中的产生式,那么γδα也是一个句子形式。
句子由初始符按照重写规则推导 (Derivation) 出来的句子形式,其中不含非终结符的句子形式称为G 生成的句子。
语言(Language)
由文法G生成的语言是指G生成的所有句子的集合,记作L(G)

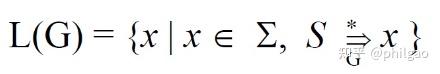
start symbol = S
non-terminals = {S}
terminals = {a, b}