
|
|
相关文章推荐

|
八块腹肌的荒野 · 《世界军事战争史-117》拜占庭及欧洲军事思 ...· 1 年前 · |
|
|
酒量小的水煮鱼 · 广东省医疗纠纷预防与处理办法· 1 年前 · |
|
|
乖乖的骆驼 · 三看小微企业——浙江小微企业一线观察· 2 年前 · |
|
|
私奔的山楂 · 消除演讲紧张!如何克服上台演讲时身体晃动|口 ...· 2 年前 · |
本文提出一种基于图匹配的领域自适应目标检测算法。简单的介绍一下领域自适应目标检测(DAOD)任务,通常做目标检测是假设训练样本和测试样本是来自同一个分布的(可以简单理解为同一个数据集),而实际上测试样本的来源可能非常多样(来自不同数据集)。我们将训练样本所处的分布称为源域(source domain),将测试样本所处的分布称为目标域(target domain),为了提高对于来自不同分布样本的检测能力,提出了领域自适应(Domain Adaptive)的想法。现有的方法通常是在特征空间中为每个类别的目标定义一个prototype,比如特征向量的均值,作为类别中心。然后通过训练让源域和目标域中同类别的prototype尽量对齐,为每个类别的目标都找到一个公共的分布,以实现领域的自适应。作者认为这样做有两个弊端:1. 这种类别相关的“紧凑的”分布会使得网络丧失一定的分布感知能力,进而影响泛化能力;2. 训练过程中,由于每个batch的图像都是随机选取的,会存在某些类别的目标只在源域或目标域中出现,导致语义上的错误匹配(比如由于当前源域图像中没有猫这个目标只有狮子,而目标域的图像中有猫,就有可能把猫匹配到狮子上去),这有可能影响类别中心的更新。
为了解决上述的问题,作者提出一种基于图的建模方法,不再使用prototype来建模类别条件分布,而是用更加具体的图的形式来构建。如果说prototype是用“猫”这个字来描述猫这个类别,那图则是用“猫头”、“猫腿”、“猫身”和“猫尾巴”这种稠密的方式来描述猫。不仅可以通过各个节点之间边来进行图内的信息传递,还可以利用跨图连接实现不同的图之间的信息交互(cross graph interaction,CGI)。对于缺失的类别,作者提出一种虚拟节点的概念,从一个存储着所有类别目标特征信息的图记忆银行(graph-guided memory bank,GMB)中采样得到缺失类别的节点来补全图,称之为图嵌入的语义补全模块(Graph-embedded
Semantic Completion module,GSC)。最后采用双边图匹配方法(Bipartite Graph Matching,BGM)实现源域图和目标域图之间的对齐。
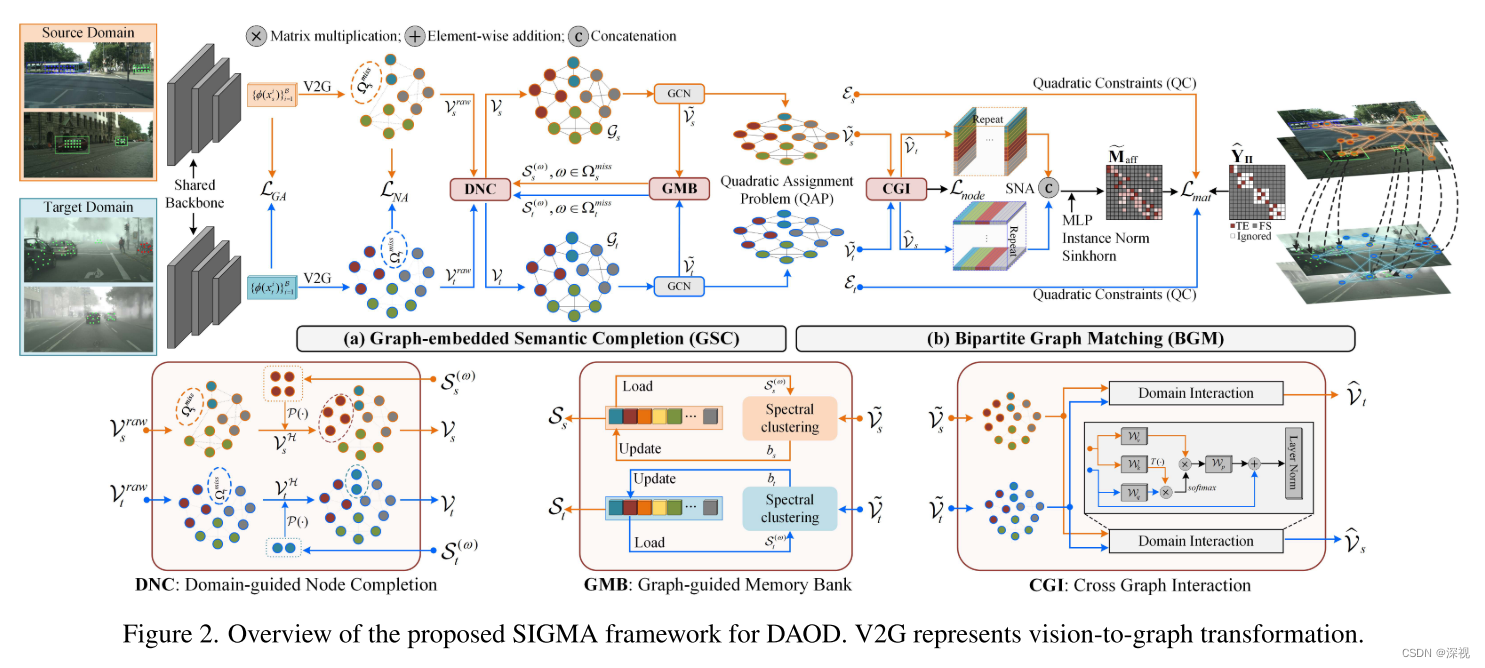
首先,来自源域和目标域的图片分别经过一个共享权重的特征提取网络得到对应的特征图,为构建图模型需要将视觉特征转化成图(V2G)。对于源域图片,由于已知每个目标的标签和位置,因此可以根据目标的外接框所在位置,从特征图上进行均匀采样得到特征点。并且对于外接框外部的背景图像也按一定比例采样特征点,再利用一个非线性映射层得到对应节点特征
\tilde{v}_{s/t}^i=LN(\sum^{|NR^i|}_{v_{s/t}^i \in NR^i}A_{s/t}^{i,j}v_{s/t}^jW_{gcn} + v_{s/t}^i)
v
~
s
/
t
i
=
L
N
(
v
s
/
t
i
∈
N
R
i
∑
∣
N
R
i
∣
A
s
/
t
i
,
j
v
s
/
t
j
W
g
c
n
+
v
s
/
t
i
)
其中
S_{s/t}^{(w)}\leftarrow sim(b_{s/t},S_{s/t}^{(w)})S_{s/t}^{(w)} + [1 -sim(b_{s/t},S_{s/t}^{(w)}) ]b_{s/t}
S
s
/
t
(
w
)
←
s
im
(
b
s
/
t
,
S
s
/
t
(
w
)
)
S
s
/
t
(
w
)
+
[
1
−
s
im
(
b
s
/
t
,
S
s
/
t
(
w
)
)]
b
s
/
t
其中
sim(b_{s/t},S_{s/t}^{(w)}) =\frac{b_{s/t} \cdot S_{s/t}^{(w)}}{\|b_{s/t}\|_{2}\cdot \|S_{s/t}^{(w)}\|_{2}}
s
im
(
b
s
/
t
,
S
s
/
t
(
w
)
)
=
∥
b
s
/
t
∥
2
⋅
∥
S
s
/
t
(
w
)
∥
2
b
s
/
t
⋅
S
s
/
t
(
w
)
b_{s/t}=\frac{1}{|\pi_{s/t}^{seed}|-1}\sum_{\tilde{v}_{s/t}^{(w)}\in \pi_{s/t}^{seed}}\tilde{v}_{s/t}^{(w)}
b
s
/
t
=
∣
π
s
/
t
see
d
∣
−
1
1
v
~
s
/
t
(
w
)
∈
π
s
/
t
see
d
∑
v
~
s
/
t
(
w
)
最后,看看如何通过双边图匹配实现跨领域的对齐任务。上文提到构建图的时候聚合了不同图像之间的信息,而这里的不同图像是指同一个域内的不同图像,只是在一个图
\hat{V}_s=LM\{softmax[(\tilde{V}_sW_q)(\tilde{V}_tW_k)^T](\tilde{V}_tW_v)W_p +\tilde{V}_s \}
V
^
s
=
L
M
{
so
f
t
ma
x
[(
V
~
s
W
q
)
(
V
~
t
W
k
)
T
]
(
V
~
t
W
v
)
W
p
+
V
~
s
}
\hat{V}_t=LM\{softmax[(\tilde{V}_tW_q)(\tilde{V}_sW_k)^T](\tilde{V}_sW_v)W_p +\tilde{V}_t \}
V
^
t
=
L
M
{
so
f
t
ma
x
[(
V
~
t
W
q
)
(
V
~
s
W
k
)
T
]
(
V
~
s
W
v
)
W
p
+
V
~
t
}
其中
L_{NA}=-\sum_{i}^{N_s}Dlog\{f_{dc}[f_b(v_s^i)]\}-\sum_{i}^{N_t}(1-D)log\{f_{dc}[f_b(v_t^i)]\}
L
N
A
=
−
i
∑
N
s
D
l
o
g
{
f
d
c
[
f
b
(
v
s
i
)]}
−
i
∑
N