


python爬虫(1) : 爬取百度图片
最近在自学python的爬虫方法,总结了一些笔记在此分享。
先以搜索词“哆啦A梦”为例:
我们在百度图片中搜索“哆啦A梦”,向下滑动网页时,图片会不断加载,因此该网页是动态加载的网页,按F12,选择网络,在消息中选择过滤XHR消息。

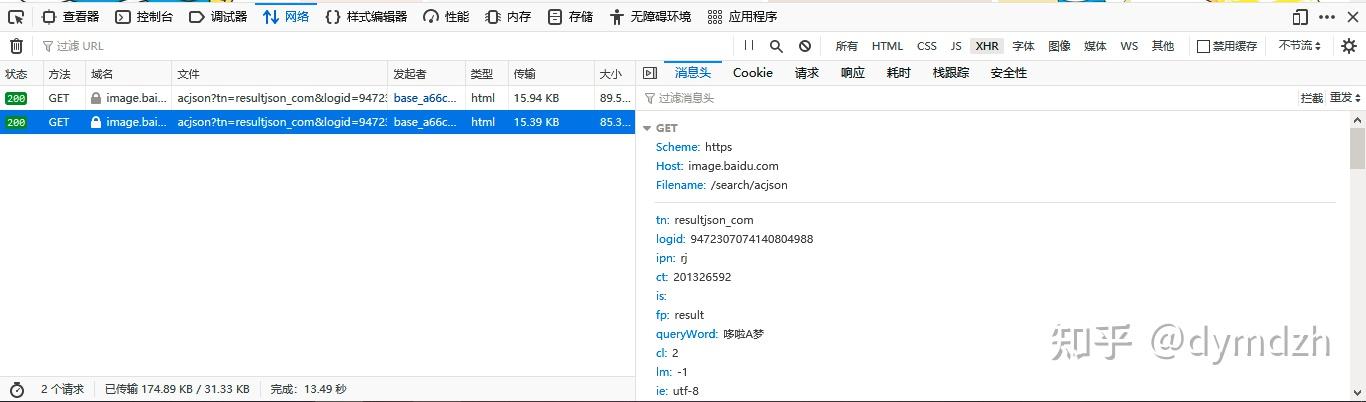
查看响应消息,可以看出,该请求为GET请求,返回的是一个JSON文件,里面的data蕴含着我们想要获取的每个图片的url。

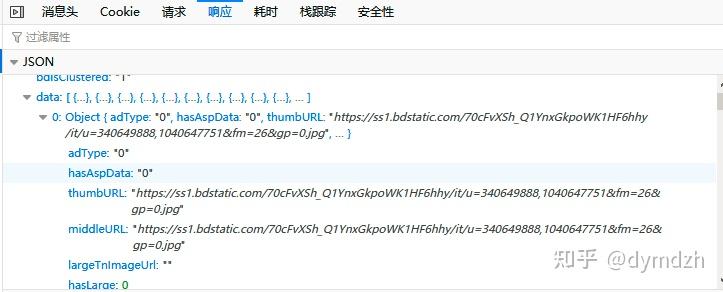
由此,我们可以利用requests模块的get方法模拟浏览器发送请求,获得其对应的JSON数据。
可能使用到的头文件有:
import re
import os
import requests
使用requests模块的get()方法可以获得一个网址的源码,其中params里面的参数可以右键-复制全部得到。然后通过key="data"获取我们想要的url。
    url = 'https://image.baidu.com/search/acjson'
    params={
            "tn": "resultjson_com",
            "logid": "11555092689241190059",
            "ipn": "rj",
            "ct": "201326592",
            "is": "",
            "fp": "result",
            "queryWord": "哆啦A梦",
            "cl": "2",
            "lm": "-1",
            "ie": "utf-8",
            "oe": "utf-8",
            "adpicid": "",
            "st": "-1",
            "z": "",
            "ic": "0",
            "hd": "",
            "latest": "",
            "copyright": "",
            "word":"哆啦A梦" ,
            "s": "",
            "se": "",
            "tab": "",
            "width": "",
            "height": "",
            "face": "0",
            "istype": "2",
            "qc": "",
            "nc": "1",
            "fr": "",
            "expermode": "",
            "force": "",
            "pn": 0,
            "rn":"60" ,
            "gsm": "1e",
            "1617626956685": ""
    result = requests.get(url, headers=header,params=params).json()
    url_list=[]
    for data in result['data'][:-1]:
        url_list.append(data['thumbURL'])
url_list为一个有60个元素的列表,每个元素对应一张图片的链接。
最后一步,遍历url_list中的所有元素,逐个下载保存即可。
    def getImg(url,idx,path):
        img=requests.get(url,headers=header)
        file=open(path+str(idx)+'.jpg','wb')
        file.write(img.content)
        file.close()
   for i in range(len(url_list)):
        getImg(url_list[i],60*page+i,path)
值得注意的是,请求参数中的"word"和"queryword"为我们的关键词,"pn"表示开始索引,"rn"表示获取的张数(每一页最多可获取60张图片,要想获得更多图片,重复发请求即可)。
最后完善一下交互操作即可实现自动爬取百度图片。
import re
import os
import requests
import tqdm
header={'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/66.0.3359.139 Safari/537.36'}
def getImg(url,idx,path):
    img=requests.get(url,headers=header)
    file=open(path+str(idx)+'.jpg','wb')
    file.write(img.content)
    file.close()
search=input("请输入搜索内容:")
number=int(input("请输入需求数量:"))
path='image/'+search+'/'
if not os.path.exists(path):
    os.makedirs(path)
bar=tqdm.tqdm(total=number)
page=0
while(True):
    if number==0:
        break
    url = 'https://image.baidu.com/search/acjson'
    params={
            "tn": "resultjson_com",
            "logid": "11555092689241190059",
            "ipn": "rj",
            "ct": "201326592",
            "is": "",
            "fp": "result",
            "queryWord": search,
            "cl": "2",
            "lm": "-1",
            "ie": "utf-8",
            "oe": "utf-8",
            "adpicid": "",
            "st": "-1",
            "z": "",
            "ic": "0",
            "hd": "",
            "latest": "",
            "copyright": "",
            "word": search,
            "s": "",
            "se": "",
            "tab": "",
            "width": "",
            "height": "",
            "face": "0",
            "istype": "2",
            "qc": "",
            "nc": "1",
            "fr": "",
            "expermode": "",
            "force": "",
            "pn": str(60*page),
            "rn": number,
            "gsm": "1e",
            "1617626956685": ""
    result = requests.get(url, headers=header,params=params).json()
    url_list=[]
    for data in result['data'][:-1]:
        url_list.append(data['thumbURL'])
    for i in range(len(url_list)):
        getImg(url_list[i],60*page+i,path)
        bar.update(1)